
#01
前言
或许你是一名设计师、建筑师、摄影师,或者是从事数字文化研究和数据科学的人。而这本书是第一本将所有这些不同观点结合起来思考创造性人工智能的书。我们从2019 年夏天开始编写这本书,在此过程中,我们交换了大量信息,互相分享了彼此的想法,并共享了部分草稿。而这本书就是这个过程的结果。虽然每一章都是由其中一位作者撰写的,但它反映了我们 27 个月以来的讨论。
#02
_即使是人工智能_
_也能做到这一点_
什么是美学?
想想我们在日常生活中做出的许多审美的选择——挑选和搭配衣服、点赞图片、选择发型、化妆、参观、购物、听音乐等等。在所有这些例子中,美学是指由我们的感官调节的愉快体验,这个词也可以包括风格和审美判断等概念,这些概念可以评估艺术品的价值。尽管美学与艺术之间的关系已成为当代争论的对象。但在创建图形、捕捉和编辑照片和视频、绘制图像以及设计空间和建筑时,我们也会做出日常美学的决策。 美学涵盖自然、人造物,以及体验。
21 世纪以来,计算、数据分析、机器学习、神经网络和人工智能——一个个包罗万象、引人入胜、定义不断变化的标签,都逐渐进入了审美领域。例如,Spotify、Apple Music 和 Pandora 等音乐流媒体服务会自动推荐我们可能喜欢的音乐。Instagram 的“Explore”选项卡会自动为每个用户推荐个性化的照片和视频。一键美化是所有用于编辑照片的移动和桌面应用程序的标准功能。大型在线时尚零售商会自动为搭配提供建议,等等。
这些系统依赖于越来越复杂的方法来预测人们可能喜欢什么。例如,深度神经网络通过直接观察人们的审美选择来学习审美的原理。早期对图像质量评级的预测是基于经典的构图规则(如三分法、纵横比、饱和度等)以及程序员对审美价值的直觉,这种直觉来自于他们对最受欢迎的照片的观察。后来,神经网络逐渐被用于分配语义标签(“价值”),并通过分析人们喜欢的图像的大型数据库自动提取与美学相关的特征。
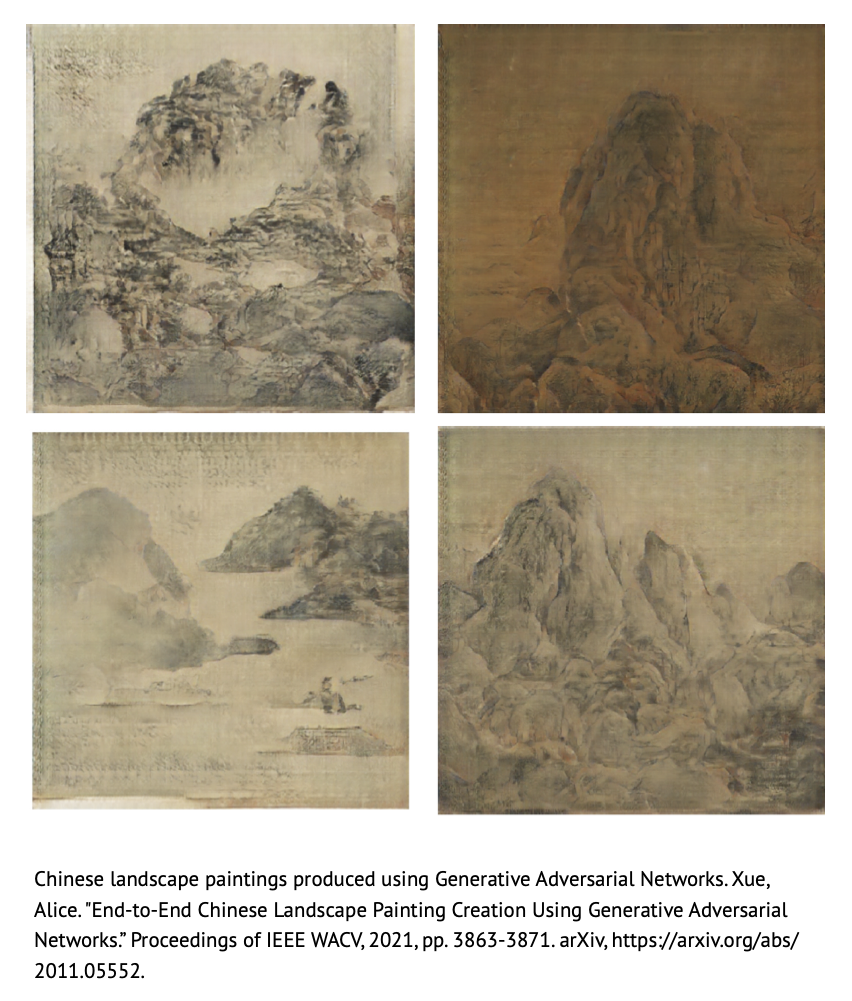
除了推荐和自动编辑之外,人工智能现在还被广泛用于生成新的人工智能制品,包括艺术作品、音乐、设计和文字作品。例如,在 2016 年,通过分析伦勃朗的 346 幅已知画作来训练深度学习算法学习他的风格。该算法随后被赋予生成一幅全新肖像的任务,其结果看起来像真正的伦勃朗的作品。同年,巴黎索尼计算机科学实验室的研究人员开发了一种名为 DeepBach 的神经网络,可以产生J.S.Bach风格的合唱。从那时起,其他音乐生成算法也开始被创造出来。
人工智能与美学的相遇至关重要,因为美学被认为是一个典型的人类领域。它的难处理性和复杂性长期以来一直被认为不受算法简化的影响。对一些人来说,艺术、美学和创造力是人类能力的巅峰,因此代表着对抗似乎势不可挡的人工智能进步的最后一道堡垒。换句话说,这个复杂的领域将成为人工智能可能性和局限性的最终试验场。
尽管如此,仍然有一种流行的观点认为,像上文提到的那些开发只是模仿现有的风格,根本没有创造性。 在这些情况下,计算机接收预先存在的示例并生成符合其模式的变体,同时尝试引入某种程度的变体。有时,它们与真正的艺术品惊人地相似,但这也可能意味着它们在训练有素的人看来似乎有些偏离,缺乏使它们成为令人信服的人类的最后润色。这些算法不会生成全新的音乐或绘画风格,相反,它们是我们可以称之为计算方式主义的实例。
但是,即使是专家也会被“欺骗”, 人工智能制作出比人类作品更有美感的艺术品,这可能只是时间问题。上文提到的例子涉及大量重复和低可变性的艺术品集:这些品质使神经网络能够提取一般特征,并容易生成新的例子。换句话说,制作传统或古典艺术作品似乎特别简单,因为它们倾向于显示出清晰、可识别的风格,并遵循艺术家、学派或传统的特定模式。机器学习系统非常适合分析大量出现的具有轻微变化的对象类型,并提取相关的特征和模式。相反,复制像杜尚风格的作品是非常困难的,因为人工智能必须从这个艺术家的非常不同的作品数据集开始,包括《泉》、《瓶装啤酒》、《大玻璃》、遗作《给予》等等。通常情况下,保守的艺术观点将技术掌握程度视为“真正艺术”的标准,许多人仍然不认为不需要技术能力的东西就是艺术。然而,技术能力意味着程序性知识,而AI正是用来处理这类知识的。清晰可识别的风格是定义明确的问题,可以简化为计算任务,而不遵循组合规则(如杜尚的作品)的变体的生成则导致定义模糊的任务,没有简单的程序解决方案。讽刺的是,针对当代艺术的流行陈词滥调现在似乎反过来反对文化传统中伟大且风格复杂但计算上可扩展的艺术:即使是人工智能也可以做到这一点。而杜尚仍处于人工智能创造力之外,至少目前是这样。
以下是我们要处理的主要问题的简要概述。
要研究人工智能和机器学习对美学的影响,首先需要对美学和计算方法相结合且相关联的领域进行总体映射(见下一节“人工智能与美学的关系:一张简单的映射表”)。然后,我们将进一步展示所谓的实验美学和计算应用之间的一些关联点,展示如何将在前者中发现的一些限制和临界点转移到后者所采取的方法中(见“计算与心理学”一节)。
技术是工具的发展,延伸了我们的范围和力量。 我们的体力在生物学上是有限的:多亏了杠杆、齿轮和引擎,我们成功地克服了这些限制。我们的视力在生物学上也是有限的,但显微镜和望远镜允许我们放大可见的范围。类似地,我们的认知技能,如计算和记忆,也有上限,但计算器和计算机增强了这些技能。按照这条论证路线,我们可以认为审美能力也有人类的局限性,可能有一个点达到了创造力或审美的顶峰。限制既由个人决定,个体有自己的敏感性、创造力和技能,也由文化作为一个整体来决定,文化在一个特定的艺术媒介中界定了什么是可能的。人工智能美学可以被描述为我们审美技能的增强,加深了我们的创作过程以及我们对文化艺术品的理解和敏感性。先进的系统将是创意学科中已经使用的设备的进一步发展,如图形程序、计算机辅助设计技术、音乐软件等(见第二章和第三章创意、媒体理论和数字文化)。如果从传统意义上说,媒体是人类感官的延伸,那么人工智能则是人类调解人类与世界之间关系的能力的进一步延伸。
我们与技术的接触扩大和改变了我们创造和最终塑造文化进化的方式。 问题是,所有这些是否有可能突破我们对人类文化和艺术遗产的认识界限。在未来场景中,机器可以获得人类审美偏好的精确理解,最终以比人类更高的精确度记录我们在审美对象面前的感知和反应。机器可以学习产生审美人工智能作品,并产生新的创作风格和流派。通过分析人类美学和人类文化中美学的多样性,他们甚至可以创造新的“文化”——也就是说,创造真正的新型艺术和美学。
在围绕人工智能的讨论中,我们经常听到机器如何“解决”我们认为是人类独有的领域,或者比人类竞争对手取得更好的性能。在每一种情况下,应该被视为真正人类和智能行为的标准都会被提升并转移到其他领域。 我们见证着机器无法再生的区域是如何缩小的。 有人可能会想,我们现在是否正在审美领域目睹这种缩小的过程。这就产生了这样的问题: _机器能达到我们认为它们真正有创造力的地步吗?机器如何应对当代艺术运动中的概念转变?他们在帮助我们理解“好品味”和“坏品味”方面能起到什么作用?使用数据分析的系统是利用了我们文化的“无意识”结构,还是我们见证了一种全新的文化生产形式的出现?_(见第三章:“美学、人工智能和人类”)。
1750年,德国哲学家Alexander Baumgarten提出了美学作为一门哲学学科的最初定义,并引用了古希腊美学,即感觉或感知。康德后来在他的《判断力批判》(1790)中把这个词重新定义为对品味的主观判断。这意味着美学将感知视为一个比感官体验更复杂的概念(如今由感知心理学进行研究),因为它还试图解决我们对感知的情感和认知反应。机器学会识别人类无法检测到的数据中日益复杂的模式。所有这些都提出了以下问题: 机器感知和模式识别机制在多大程度上与“审美感知”相关,以及人类审美感知的哪些典型方面仍需要人工智能系统来处理?(见第四章“机器和无辜的眼睛”)。
#03
_人工智能与美学的关系:_
一张简单的映射表
正如我们所看到的,美学的计算方法涵盖了广泛的应用,从文化艺术品的分析到它们的产生,处理的问题如下:
_a)我们能否开发出提取艺术品或图像的所有相关特征的系统?我们能否分析或描述某一特定文化传统中艺术品的审美特征?从另一个角度来看,我们也对这样的问题感兴趣:b)我们能用人工智能来理解和预测人们喜欢什么吗?_
我们可以看到关于客体的问题和关于主体的问题之间的区别。关于第一个,我们关注人工智能作品的形式和表达特征(例如,绘画风格、主题、形状和笔画的组织、与其他作品的形式相似性),以及它们的语义和意义。另一方面,当我们处理与主题相关的问题时,我们要处理观众的审美体验和感知,包括对艺术价值的判断、欣赏、情感和认知反应等。
客观与主观区分了计算方法中发现的两种完全不同的观点:第一种观点涉及对对象的分析,旨在从大型的审美人工智能作品和文化产品数据库提取模式和风格不变量。主观分析(并预测)人工智能作品的哪些特性与人们的审美反应、感觉和解释(无论是个人还是集体)相关。
另一个区别是机器学习既用于从数据中提取模式,也用于在使用所述数据进行训练后生成模式。因此,这些技术的发展不仅允许我们描述人工智能作品和预测人的行为,还可以通过它们来生成人工智能作品和模拟人的行为。因此,还应该添加其他类型的问题: _我们能否(重新)生产人们喜欢的作品,并生产出具有美学价值的新作品?我们能否建立人们审美偏好的计算模型,从而模拟并自动化他们的判断?_
通过跨越客观与主观、识别与生成这两对维度,我们可以识别机器学习和人工智能在美学中的四种不同应用:
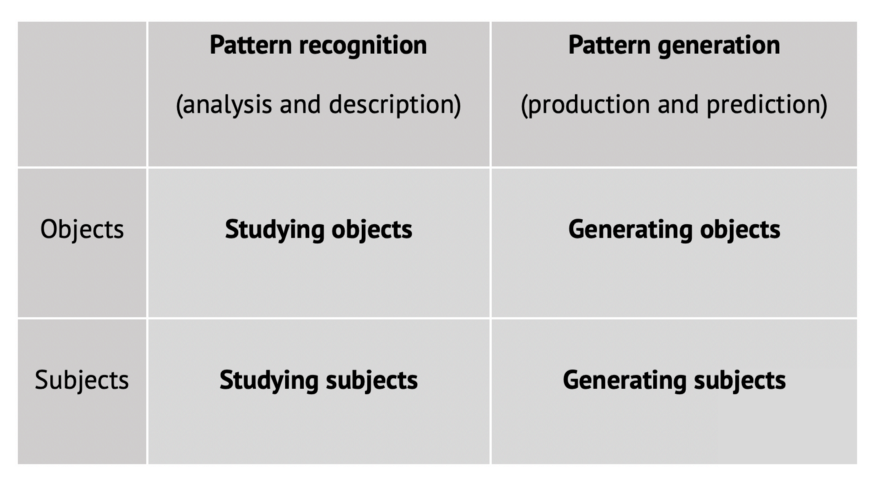
为了说明这张映射表的不同领域,让我们想一想Johann Sebastian Bach的作品。他的音乐被描述为高度结构化和数学化的,可以说是“音乐中的国际象棋”,并且一直是算法描述和生成的对象(例如 2016 年的“DeepBach”项目):
1)“客观识别”: 人工智能使用包含巴赫所有作品的数据集,分析旋律模式,追踪不同乐谱之间的相似性,提取作曲家的特征风格;2)“客观生成”:使用巴赫作品数据集训练的人工智能用于生成新的巴赫音乐变体。
然而,如果这些任务(分析音乐作品的形式特征和变体的产生)未能考虑人们对音乐的反应和体验,就会错过美学分析的一个重要方面。这就是受试者反应的问题所在:
3)“主观识别”:收集和分析偏好,以确定特别喜欢哪些音乐特征或哪些音乐品质决定了特定的审美反应(感觉、情绪等)。想想在线音乐平台如何通过算法跟踪用户喜好。如果个人喜好之间的差异不是太大,则可能可以在巴赫作品领域建立审美评价模型。该模型可以预测用户将如何评估新的巴赫作品。接着,听众会听到这些新作品并为模型提供进一步的反馈。如果用户反应的差异太大,我们可以使用聚类分析来识别不同类型的偏好,并生成适合每种类型的不同模型。这种方法与根据人口统计学、兴趣、需求、行为或位置将其市场客户细分成更小的群体的公司没有什么不同。事实上,根据以往的选择来描述和预测人们的审美行为,构成了将传统消费者偏好分析作为营销和社会学研究实践的演变和提炼。然而,现代方法以一种提供新的分析能力的方式使用数据。虽然传统的市场和社会学调查通常汇集数据、使用聚合统计平均值,并根据人类类型的理论社会学模型形成集群,但数据的算法跟踪和分析能够生成使用个人行为作为数据的个人档案,例如点击或点赞社交网络上的特定图像或收听 Spotify 或 Youtube 上的特定音乐。每个数据文件对一个人来说都是独一无二的,而不是将来自许多主题的数据聚类。
4)“主观生成”:在线平台上的推荐系统使用模型来预测用户会喜欢什么。然而,通过建模一个人的审美判断,也可以产生行为和判断。原则上,对听众的偏好和审美反应进行建模使我们能够模拟人们在特定物体面前的行为和反应。如果作曲家(或人工智能本身)要创作一种新的巴赫式音乐变体,那么根据主体的审美模型训练的人工智能系统可以自行制定评估,而无需参考人类主体。
不难想象,“人工智能判断”系统在未来可能会越来越多地被使用。 这些系统将自动评估文化作品,对具有更高或更低审美价值的设计工艺品、时尚单品或图像进行评分。人工智能判断可以做的不仅仅是告诉我们“我们可能还喜欢什么”(例如传统推荐系统)。它还可以告诉我们“有多少人会欣赏”,人们将如何判断它,甚至预测人们会告诉我们什么。
用于预测图像美学评分的自动化系统是人工智能判断的典型例子。这些功能结合使用客观指标(图像质量、清晰度、最佳对比度、颜色等)和主观评价来实现。为了创建这样一个系统,大量的人会对大量的图像进行评分。然后使用这些数据来训练神经网络,该网络随后可以自动对新图像进行评分。此外,这些算法能够识别出人们甚至不知道的审美属性(在客观方面)和个人偏好(在主观方面),但这些都体现在他们的欣赏行为中。
#04
_当我们谈论美学时_
我们会做什么
计算分析可能使我们能够提取模式和形式结构,但它无法理解这些模式如何影响人类感知、情感和认知。 脱离人类意义而考虑的模式最终是空洞的。 艺术史学家 Michael Baxandall(在他 1985 年的著作Patterns of Intention 中)有说服力地描述了我们在谈论任何艺术品或文化产品时使用的批判语言的本质。对于 Baxandall 来说,我们创造的任何话语都不仅仅是对特征的事实描述,也不是一个人反应的主观报告,而是强调对象和人类反应(它们赋予的意义和它们表现出的审美反应)之间的关系。这种关系进一步通过对对象的象征意义和文化意义的理解来调节。可以这么说,评论家告诉读者在特定对象面前预期(或过去人们会预期)什么样的反应。用上一节的映射术语表达,这意味着在客观的描述和相应主观反应的描述之间建立联系。
按照 Baxandall 的说法,艺术中的文化和批判性解释不仅仅是描述或分类,它们“主要是我们对它的想法的表征”(意图模式,第 10 页)。我们所描述的是一种“部分解释性描述”——“描述的不是图片,而是我们看到图片的想法”或至少是对这些想法的假设。评论家论证的效力在于他能够说服读者相信作品会引起评论家声称要明确表达的那种反应和想法。而且,评论家对词语和概念的运用,在强化对对象的感知的同时,也加深了概念本身的含义——“概念和对象相互强化”(意图模式,第 34 页)。例如,如果我们将Edvard Munch的《呐喊》 (1893) 描述为激发一种恐惧感,那么以蒙克的名画为例,恐惧作为一种美学概念的概念将更加丰富。
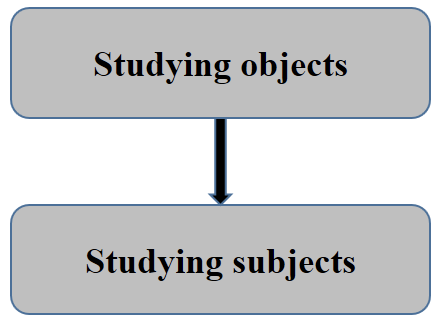
合成媒体中的人工智能制品(图像、歌曲、文本)是由已经在类似的、预先存在的人工智能制品的大型数据库上训练过的网络生成的,如下图所示:
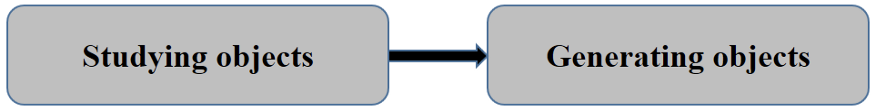
然而,如果期望生成的内容具有审美价值,那么生成网络不仅要考虑形式维度(人工智能制品是如何制作的),还要考虑其相应的主观解释和反应,包括人们的审美偏好。否则,我们将能够产生无限变化的模式,但不知道它们与我们的欣赏有何关系。如果对没有意义的模式的描述是空洞的,正如我们所说, 没有人类解释的模式的产生是盲目的。
在今天的人工智能媒体生成中,人类通过选择、调节和调整过程来操作生成网络,以获得预期的结果。这个结果还取决于人类遵循自己的审美感受,例如,一位音乐家必须对不同时代的舒伯特《未完成交响曲》进行评估和过滤。只有对主观反应(“主观识别”)的算法分析才能逐步实现这一评估步骤的自动化。
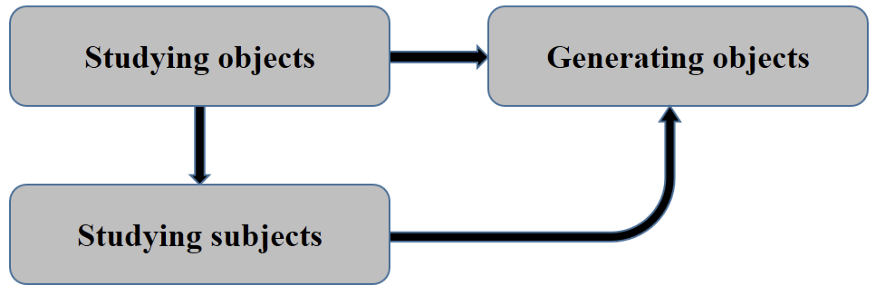
此外,“主观识别”将涉及个人和集体的反应。后者涉及分析历史上对文化作品的反应。理想情况下,一个能够创造有意义的艺术和设计的人工智能会考虑存在的历史,不仅可以从人工智能作品中推断出模式,还可以解释它们的集体接受程度,即人们随着时间的推移对这些人工智能作品的反应。因此,使用人工智能生成新的文化艺术品(并协助人类创造者)将需要使用人工智能进行文化分析。这就需要将人工智能美学与处理这个问题的各个领域联系起来——哲学美学、艺术史、艺术心理学、人类学和文化社会学等等。诚然,新技术的发展可以产生全新的人工智能作品,而不必与过去的文化产品相似。然而, 如果我们想更好地了解这些人工智能作品如何影响人们,了解我们通常如何反应并赋予审美对象以意义,可以使我们免于在黑暗中徘徊。 不久的将来可能会拥有全新的审美人工智能作品,但不太可能拥有全新的人性。
#05
计算与心理学
审美现象涉及所有人类能力之间的复杂关系,从低层次的感知机制到更高层次的情感和认知过程。 19 世纪末,实验心理学之父Gustav Fechner已经将美学认定为科学心理学新方法面临的最关键的挑战,这并非巧合。事实上,研究人们在审美体验中的反应和行为(我们定义为“研究人”的领域)长期以来一直是所谓的心理学实验或经验主义美学的传统。例如,Fechner 调查了人们是否更喜欢遵循黄金比例规则的形状。虽然 Fechner 的发现似乎证实了这一假设,但后来的研究未能复制相同的结果。这一研究领域持续了近一个世纪:例如,Birkhoff的美学测量试图用一个可量化的公式来捕捉形状复杂性和秩序之间的最佳美学关系:根据他所说,高秩序与高复杂性将与更高的审美愉悦相关联。
20世纪70年代,Daniel Berlyne的新实验美学引入了动机因素作为审美愉悦和欣赏的关键组成部分—— 审美价值不仅取决于对象的特征,还取决于主体的偏好水平,即兴趣和刺激程度。 复杂性和享受之间的倒 U 型关系表明,刺激中存在一个在太少和太多复杂性之间的最佳中间点。这一点也经过了实证研究,尽管结果不尽相同。在新世纪之交,研究人员认为有必要从基于简单抽象模式的心理实验转向观察人们在真实艺术品、人工智能作品或自然实体面前的反应。神经心理学方法最近在该领域变得流行,将它们的关注点延伸到了诸如创造力以及特定艺术形式(视觉艺术作品、音乐、电影、文学)中的接受和解释机制等问题上。
该领域的研究人员通常在严格控制的条件下,对一小群人进行实验,使用统计技术来分析收集到的数据。例如,在许多视觉美学实验中,向一组人展示特定的图像(数据集可以预先存在或专门为实验创建),并要求人们以某种方式表达他们的偏好,例如使用数字的形式对所有图像进行评分。
数十年的实验美学研究得出了许多结论。例如,心理学家发现, 长时间地接触刺激会导致对对象的熟悉程度不断提高,从而导致对它以及对象类别中的原型的偏爱。 也就是说,我们喜欢更典型的东西,以及整体流畅性,处理体验的方便性,与审美偏好有关。此外,研究结果表明,人们更喜欢面部特征的对称性,更偏爱光滑和弯曲的形状而不是棱角分明的形状;对自然景观而非人造场景的特定偏好,以及对具有自然主义美学的建筑场景的偏好。许多研究测试了和谐、平衡和“良好构图”的经典规则,例如“三分法”或格式塔理论描述的原则(最早被Rudolf Arnheim在他1954年的经典作品《艺术和视觉感知》中应用于艺术)。
今天的计算方法和传统的实验美学之间有两个关键的区别。第一, 实验美学多关注主体,而人工智能美学则更加关注客体。 此外,实验美学使用经过特殊选择和高度控制的刺激,而人工智能美学使用的是来自现实生活中人类行为的“大数据”,这些数据往往是通过数字平台收集的。
虽然实验美学通常在受控环境中产生刺激,并观察人们的反应,但计算方法利用大量可用的表达偏好的数据集,如 Photo.net 或 Dpchallenge.com(用于21世纪后的计算研究),使研究人员能够探索人们如何在社交平台上“点赞”。在其他情况下,他们捕捉并测量人们在在线平台上的实际消费者行为,例如音乐和电影的流媒体服务,目的是从最流行的人工智能产品中推断出特征。
在实验美学中,以主体为中心的方法强调对所谓的“因变量”的分析。这些包括受试者的受控反应,通过校准良好的量表进行判断,以及生理反应(心率、皮肤电导、瞳孔扩张等)和大脑活动,通过脑电图或功能磁共振成像测量,这在理论上消除了与口头评价相关的问题。另一方面,美学行为的计算分析是一种以客体为中心的方法,特别擅长描述“自变量”,即人们每天消费和判断的美学内容。这种优势源于它能够从图像、音乐和其他文化作品中收集和分析大量特征的能力。如前所述,美学计算方法的主要优势在于,它们不必寻求审美普遍性或将(相对较小的)主体群体的共同反应作为普遍态度的代表。相反,算法可以跟踪个人偏好和行为,而无需基于聚合平均值对审美反应进行建模。大数据不需要我们假设一个普遍的人类审美主题。
尽管有这些优势,但专注于审美偏好的人工智能美学仍然必须应对所有实验方法所特有的方法论挑战。我们将简要提及其中两个:
- 分离出与我们的审美评价相关的特征的难度2) 确定我们试图描述的反应类型的难度
关于第一点,审美对象的特征是难以分离的。例如,要研究一个设计项目的形状变化如何影响审美,实验应该使用受控设置来分析形状最小变化的影响,并避免同时混淆多个变化(例如,改变形状和颜色,或形状和质地等)。然而,审美变量也可以相互影响。因此,这种设置不允许我们在该特定对象上的特征和对特征的审美反应之间建立一一对应的关系。确定人们偏好的总体趋势当然是可能的。例如,我们可以观察到,在特定的国家或地区,某种音乐风格比具有特定人群的另一种音乐风格更受欢迎。然而,要达到更高的粒度并理解每个因素在最终美学效果中的确切作用并不总是那么容易的:究竟是什么让一种音乐风格比另一种更有吸引力?为了达到这种理解水平,我们需要大量相似的审美人工智能作品,且它们之间只有很小的差异。
在某些情况下,数字平台允许我们研究网络上提供的大量不同但不太异构的刺激。例如,在 2014 年的一项研究中,作者使用了来自媒体共享平台 Vine 上的微视频(长达 6 秒)中的数百个特征,来预测人们是会将它们判断为“有创意的”还是“没有创意的”。该研究使用了一个众包平台,让 284 人评判 3800 个视频。每个视频都收到了来自多个参与者的评价,计算得出的平均一致性为84%。这些功能涵盖场景内容、电影制作技术、摄影技术、构图、视觉效果、音频效果和新颖性。所有这些特征都是以数学方式定义的,并通过对视频的帧和音轨的分析从视频中自动计算出来的。作者报告了每组特征的分类准确率,结论是:“当我们将新颖性特征与审美价值特征相结合时,可以获得最佳结果,这显示了创造力的双重定义的可用性。” 单独使用时,构图和摄影技术优于场景内容(分类准确率为 77% 对 73%),而新颖的视频特征优于新颖的音频特征(74% 对 63%)。要得到这样的结果,就必须有一个足够广泛的数据集,其特征是可管理的(比如一部 6 秒的短片),这在人类文化生产中并不总是如此。
关于第二点,人类的审美反应(即心理实验中的因变量)也提出了其挑战。当我们询问一个人关于他的审美经验时,我们实际测量的是什么?我们与审美对象的关系有很多层次和维度。它们的范围可以从亚个体层面的生理反应到复杂的批判公式,从对社交网络中的图像的“点赞”,到实际的消费行为,再到复杂的批判性判断。我们会得到不同的答案,这取决于我们是问一个人是否“喜欢”一部电影,还是认为它是否是一部杰作,或者我们只是观察他看电影时的生理反应。
此外, 我们应该区分价值判断和单纯的主观偏好或欲望。 一般来说,我们可以说价值判断比对某个特定对象的短暂偏好或欲望更稳定。我可以认为歌曲X是杰作(并且优于歌曲Y),但目前缺乏听X的欲望,反而是想听Y的欲望更强烈,可能是因为我的情绪状态或因为我听了X太多次了。这意味着我的消费行为可以揭示一些偏好,但不一定能表达我对美学价值的总体看法。我可能是动作电影的狂热消费者,但却认为艺术电影在美学上更优越,即使我很少看它们。如果我们想避免在人工评估和生成算法中使用过于简单的人类审美经验和判断模型,那么收集有关人类审美消费数据的人工系统应该考虑这些问题。
#06
领取chapter1
回复公众号关键词:「人工智能美学第一章」,即可领取电子版pdf。
知识的价值在于分享,如果你们也有看到很不错的书籍,想分享给我们,欢迎评论区留言~。
ABOUT US
参考文章:
《Artificial Aesthetics》
作者:Lev Manovich
译者:设计小菌
为尊重版权和译者
转载请联系我们